多语言GEO监测:如何核对两种Query真的在问同一件事
直译准确不代表问题等价。从客户任务、约束条件、术语和品牌表达四个维度,人工核对跨语言GEO监测问题。
出海品牌做GEO监测时,团队通常会为不同语言市场准备各自的监测问题集。一个容易被忽视的问题是:中文版的"AI搜索排名优化"和英文版的"AI search visibility optimization",看起来像是一回事,但它们真的在问同一件事吗?
如果答案是否定的,后续的所有分析——提及率对比、回答内容聚类、竞品可见度排名——都建立在错位的基础上。你比较的不是同一个问题在不同语言市场的表现,而是两个不同的问题各自得到了什么回答。
上一篇双语内容协作指南解决了内容生产侧的事实一致性问题:术语表、风格指南、翻译记忆库确保中英文官网讲的是同一套产品事实。本文要解决的是监测侧的问题:当你已经有一套双语监测问题集时,如何人工核对它们在语义上真正等价。
为什么直译不够用
跨语言Query对齐的第一个陷阱是把翻译正确等同于语义等价。翻译工具可以给出语法正确、词汇对应的译文,但它无法判断这个译文在你的业务语境下是否指向同一个客户任务。
举一个假设的例子。中文监测问题是"企业如何用AI提升搜索引擎排名",英文版本是"How enterprises use AI to improve search engine rankings"。从翻译角度看没有问题。但如果你的品牌服务的是出海SaaS公司,中文问题中的"企业"在实际执行中被理解为"中国出海企业",而英文问题中的"enterprises"被AI理解为全球任意规模的企业,那么这两个问题虽然字面对应,实际触发的回答范围完全不同。
这类差异不会出现在词典里,只会出现在真实的AI回答中。这就是为什么跨语言Query核对不能只靠翻译工具,必须加入人工判断。
四维核对框架
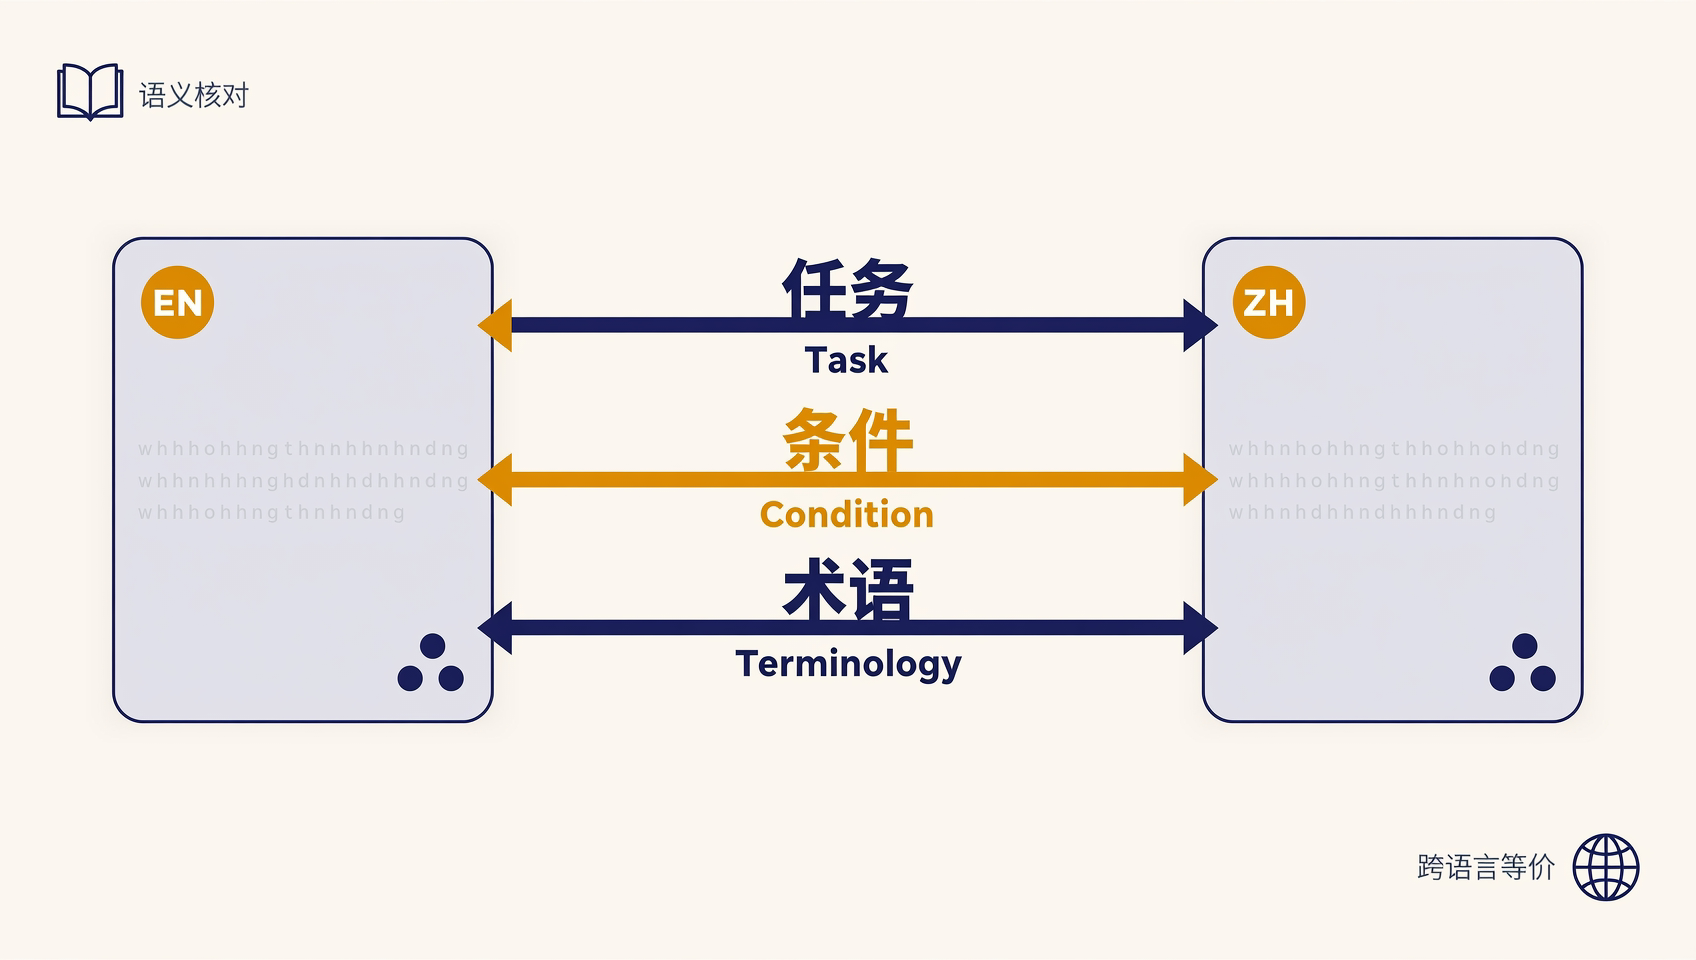
我们建议从四个维度逐一检查一对跨语言Query是否真正等价。这不是自动化流程,而是给执行者的人工核对清单。
维度一:客户任务是否相同
首先问自己:提出这个问题的用户,想要完成什么任务?
-
中文Query背后的用户是想了解方法论、寻找工具、还是评估供应商?
-
英文Query背后的用户是否有同样的意图阶段?
-
两种语言的用户是否处于相同的决策节点?
如果中文问题对应的是"初步了解GEO是什么",而英文问题对应的是"如何选择GEO服务商",即使关键词高度重合,它们也不是等价Query。
核对动作:为每个Query写一句话描述其背后的客户任务。如果两句话不能互换,Query就不等价。
维度二:约束条件是否对齐
约束条件包括地域、行业、公司规模、技术栈、合规要求等隐含前提。这些前提在单一语言环境中往往是不言自明的,但在跨语言场景中极易丢失。
继续上面的假设例子。中文版可能隐含"中国大陆企业出海"的地域约束,英文版可能隐含"北美或欧洲市场"的地域约束。如果监测目标是评估品牌在全球AI搜索中的统一形象,这种约束错位会导致你误判品牌在某些市场的可见度。
核对动作:列出每个Query的显式约束和隐式约束。逐项比对,标记不一致项。对于隐式约束,追问"这个前提在另一种语言文化中是否同样成立"。
维度三:术语体系是否一致
术语一致性是旧文已经详细讨论过的问题,但在监测场景中有一个特殊变体:同一个术语在不同语言的AI生态中可能有不同的主流表达。
例如,中文GEO领域常用的"AI搜索优化",在英文语境中可能对应"AI search optimization""generative engine optimization""AI visibility"等多个表达。如果你的英文Query使用了其中某一个,而AI平台在该语言下更习惯另一个表达,那么你监测到的回答可能不是因为这个话题不重要,而是因为你的Query没有命中该平台的主流表述。
核对动作:不要只依赖内部术语表。在目标语言的AI平台上实际测试几个候选表达,观察哪个表达能稳定触发与你业务相关的回答。将验证过的表达纳入监测问题集,并在术语表中注明"经AI回答验证"。
维度四:品牌表达是否匹配
如果你的监测问题中包含品牌名称或产品功能名称,需要确认这些专有名词在两种语言中的指代范围完全一致。
一个常见的假设场景:中文品牌名在英文市场中有一个官方英文名,但同时存在一个早期用户自发使用的非官方简称。如果你的英文Query只包含官方名称,而AI平台在该语言下更多引用包含非官方简称的内容,你的监测结果会系统性低估品牌的实际可见度。反过来,如果两个名称都被纳入监测但没有区分,你又无法判断哪些回答是由官方表达触发的。
核对动作:梳理品牌在每种语言中的所有已知表达形式(官方名称、历史别名、常见拼写变体)。确认每对跨语言Query中品牌表达的覆盖范围是对称的。
一组假设对照示例
以下示例均为假设场景,用于演示四维核对框架的应用方式,不代表真实客户案例或测试结果。
对照示例 1
中文Query:SaaS出海企业如何做GEO
英文Query:How to do GEO for SaaS companies going global
客户任务:相同:方法论探索
约束条件:中文隐含"中国企业出海",英文隐含"任意SaaS全球化"
术语体系:"GEO"在英文AI生态中有多个近义表达
品牌表达:均不含品牌名
判定:不等价:约束条件错位
对照示例 2
中文Query:AlphaRank能监测哪些AI平台
英文Query:Which AI platforms does AlphaRank monitor
客户任务:相同:功能确认
约束条件:均无隐式地域约束
术语体系:"监测"与"monitor"对应稳定
品牌表达:品牌名一致
判定:等价:四维均对齐
对照示例 3
中文Query:AI搜索优化的最佳实践
英文Query:Best practices for AI search optimization
客户任务:中文偏向"操作指南",英文偏向"行业标杆总结"
约束条件:无显式约束
术语体系:"AI搜索优化"与"AI search optimization"需验证是否为各自主流表达
品牌表达:均不含品牌名
判定:待验证:需实际测试术语命中率
这张表不是为了提供标准答案,而是展示一种可复用的核对记录格式。执行者可以在自己的项目中维护类似的对照表,每次新增或修改跨语言Query时更新。
核对之后:把结果用起来
完成四维核对后,你会得到三类结果:确认等价的Query对、确认不等价的Query对、以及需要进一步验证的Query对。
对于确认等价的Query对,可以放心地进行跨语言对比分析,例如比较同一问题在不同语言市场的品牌提及率差异。
对于确认不等价的Query对,不要强行合并分析。将它们视为独立问题分别追踪,或者重新设计使其真正对齐。
对于待验证的Query对,制定一个简单的验证计划:在目标AI平台上用候选表达分别提问,记录回答的相关性和品牌覆盖情况,选择表现最稳定的表达作为正式监测Query。需要注意的是,海外主流AI平台的语言支持范围各不相同,执行者应自行确认目标平台对特定语言的支持情况后再纳入监测。
团队应先在人工对照表中完成上述跨语言核对工作。核对完成后,在已开通的平台和问题范围内,可以使用AlphaRank观察AI回答的实际表现,并将相关记录提供给营销Agent进行分析与内容改进。具体的监测与分析能力可参考AlphaRank官网。但跨语言语义等价的判断本身,仍然需要执行者基于业务理解来完成。工具能帮你看到回答,但只有你能判断两个问题是不是同一个问题。
小结
多语言GEO监测的质量不取决于你覆盖了多少种语言,而取决于每种语言的监测问题是否真正指向同一个业务关切。直译只是起点,不是终点。
从客户任务、约束条件、术语体系和品牌表达四个维度进行人工核对,建立可追溯的对照记录,定期在实际AI回答中验证术语命中率——这套方法不复杂,但需要执行者投入对业务的理解和对语言差异的敏感度。当你的监测问题集通过了语义等价性检验,后续的分析和策略才有稳固的基础。否则,你看到的"跨语言差异"可能只是问题本身的差异,而不是市场的差异。